Przy każdej premierze nowego modelu pojawiają się rankingi, tabelki i porównania. Który model lepiej rozwiązuje zestaw zadań? Kto zdobył kilka punktów więcej? Który wygrał test przygotowany w określonych warunkach?
Nie robię takich benchmarków. Nie dlatego, że nie interesuje mnie rozwój modeli. Interesuje mnie, czy zmiana wpływa na pracę twórcy. Sama pozycja w tabeli zwykle nie odpowiada na to pytanie.
Naturalny język to sedno tej zmiany
Dla mnie ważna zmiana w AI polega na tym, że możemy mówić do narzędzia zwykłym językiem. Opisuję pomysł, dopowiadam szczegóły, zmieniam kierunek. Nie muszę najpierw poznać składni komendy, języka programowania ani specjalnego formularza.
To jest clue tych narzędzi: człowiek może pracować z maszyną przez język, którego już używa. Model może lepiej rozumieć instrukcje, trafniej reagować na niuanse i trzymać się dłuższego kontekstu. To ważne, bo zmienia sposób korzystania z komputera.
Szybszy sprzęt przyspiesza pracę. Nie każda poprawa wydajności jest innowacją
Z komputerami i kartami graficznymi jest podobnie. Nowa generacja GPU może wykonać tę samą pracę szybciej, obsłużyć większe obciążenie albo zużyć mniej energii. To ma znaczenie. Skraca czekanie, pozwala zrobić więcej prób i zwiększa dostępność narzędzi.
Sama akceleracja nie zmienia jednak tego, co potrafimy zrobić. Jeśli to samo zadanie kończy się po kilku sekundach zamiast po minucie, zyskuję czas. Jeżeli zmienia się sposób, w jaki mogę pracować, dochodzi nowa możliwość.
Rozróżnienie jest dla mnie proste: szybkość może realnie poprawić codzienny proces, ale nie każda kolejna poprawa szybkości jest przełomem. Nowy numer wersji i wyższa przepustowość nie wystarczą, by mówić o innowacji.
Co właściwie mierzy benchmark?
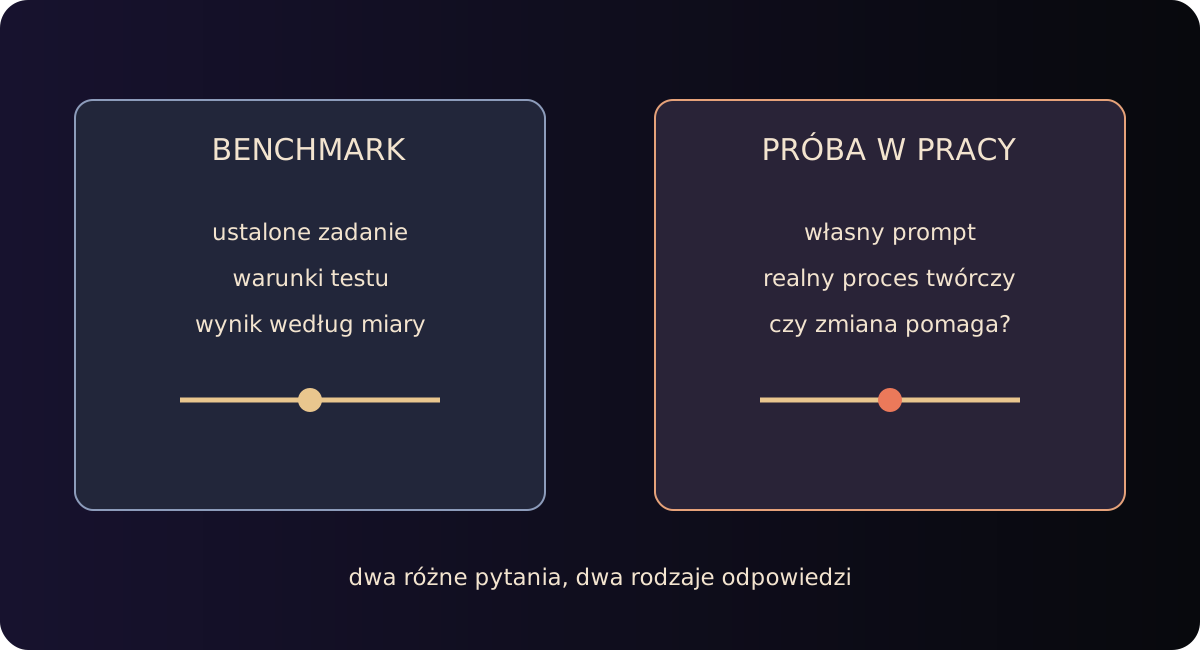
Benchmark porządkuje porównanie. Zespół wybiera zadania, sposób oceniania i warunki, a następnie mierzy wyniki. To przydatna metoda, kiedy chcemy sprawdzić konkretną cechę albo porównać modele według jawnych kryteriów. Stanford CRFM publikuje na przykład zestawy HELM, które opisują scenariusze, prompty i sposób oceny.
Każdy benchmark mówi jednak o tym, co zostało w nim zmierzone. Nie obejmuje wszystkich sposobów, w jakie ludzie korzystają z modelu. Średni wynik nie pokaże mi, czy podczas pracy nad obrazem szybciej znajduję właściwe słowa, czy model lepiej rozumie mój skrót myślowy ani czy nowa możliwość podsuwa mi pomysł, którego wcześniej nie miałem.
Nie twierdzę, że badania laboratoryjne są bezwartościowe. Dobrze zaprojektowane testy pomagają opisać zachowanie systemu. Nie zastąpią jednak próby w konkretnym zadaniu, z konkretną osobą i jej sposobem pracy.
Coraz lepsze modele, znajomy sposób pracy
Widzę, że modele stają się lepsze. Rozumieją więcej, częściej trafiają w intencję i dają sprawniejsze wyniki. Jednocześnie w wielu codziennych zastosowaniach nadal pracuję w obrębie znanego sposobu działania: wpisuję opis, dostaję wynik, poprawiam polecenie, wybieram i próbuję ponownie.
Postęp jakościowy ma znaczenie. Lepsze rozumienie promptu może oszczędzić mi kilka iteracji. Trafniejsza kompozycja może od razu podsunąć lepszy kierunek. Są to realne ulepszenia, tylko nie każda z nich zmienia metodę pracy na tyle, że muszę przygotować tabelę wyników i nowy ranking.
Wersje narzędzi mogą też różnić się funkcjami i ograniczeniami. Zanim porównamy wyniki, trzeba ustalić model, ustawienia, prompt i sposób oceny. Oficjalna dokumentacja Midjourney publikuje osobne opisy wersji i parametrów. To przypomnienie, że „nowy model” nie zawsze oznacza jeden prosty, odizolowany czynnik.
O czym piszę, kiedy zmiana naprawdę ma znaczenie?
Piszę o zmianie, gdy wpływa na moją pracę. Dobrym przykładem jest niemal natychmiastowe generowanie w Midjourney V8. Szybkość robi się wtedy odczuwalna w praktyce: mogę częściej sprawdzać warianty, pracować płynniej i dłużej utrzymać uwagę na pomyśle.
Nie chodzi o to, że szybkość sama w sobie jest nieistotna. Jeśli czekanie przestaje wybijać z rytmu, zmienia się doświadczenie pracy. Warto o tym napisać, bo twórca odczuje tę zmianę bez studiowania tabeli benchmarków.
Interesują mnie też nowe możliwości, które zmieniają sposób tworzenia: inny rodzaj kontroli, nowy sposób pracy z obrazem, lepsze utrzymanie konkretnego zamysłu albo coś, co wcześniej wymagało obejścia. Wtedy testuję funkcję, pokazuję przykłady i opisuję, co daje mi w codziennej pracy.
Mój test zaczyna się od własnego zadania
Zamiast odtwarzać cudzy ranking, wolę sprawdzić funkcję w pracy, którą znam. Na przykład zaczynam od krótkiego promptu: a mysterious figure. Dodaję połączenie polskiego surrealizmu i japońskiej ilustracji Edo, a później sprawdzam, czy model potrafi pójść w mniej oczywistą stronę.
Zapisuję wersję modelu i ustawienia. Porównuję wyniki przy podobnym punkcie wyjścia. Zadaję sobie pytania: czy model lepiej uchwycił intencję? Czy mniej czasu zajęło mi znalezienie interesującego kadru? Czy nowy efekt daje mi coś, co chcę rozwijać?
Taki test nie tworzy uniwersalnego rankingu. Pokazuje, co wydarzyło się w moim konkretnym procesie. Tę wiedzę mogę przekazać innym twórcom razem z promptem i ograniczeniami próby.
Po co więc śledzę nowe modele?
Śledzę je, bo narzędzia są częścią mojej pracy. Nie chcę jednak opisywać każdej premiery tak, jakby sam nowy numer wersji zmieniał wszystko. Gdy nowy model szybciej generuje, lepiej reaguje na język albo dodaje funkcję, która otwiera nowy sposób pracy, sprawdzam, co to oznacza dla twórcy.
Benchmark może odpowiedzieć na wąskie pytanie w przejrzystych warunkach. Własna próba odpowiada na inne: czy ta zmiana jest dla mnie użyteczna? Obie rzeczy mogą mieć sens, jeśli wiemy, na które pytanie patrzymy.
Nie robię benchmarków nowych modeli, bo nie chcę powielać laboratorium w postaci kolejnej tabeli. Wolę pokazać, co nowa wersja zmienia przy biurku, na ekranie i w samym procesie tworzenia. Gdy pojawia się przełom, napiszę o nim. Gdy model jest po prostu sprawniejszy w znanym zadaniu, powiem, co przyspieszył i komu to pomoże.
Źródła i dalsza lektura
- Stanford CRFM: HELM Capabilities - opis scenariuszy, jawne prompty i odtwarzalne wyniki benchmarku.
- Midjourney: Version - dokumentacja wersji i dostępnych funkcji.
- Midjourney: Parameter List - lista parametrów i ich działania.
- Jak szukać inspiracji do tworzenia obrazów AI? Łączenie stylów w Midjourney - przykłady pracy z promptem i własną selekcją.